Le périmètre des chiffres, avant toute conclusion
Le point de départ est un budget EC2 en architecture x86 passé d'environ 780 000 $ sur une année à environ 635 000 $ l'année suivante, à charge fonctionnelle comparable. L'écart annuel annoncé est de 145 000 $, soit environ 12 083 $ par mois, avec des mensualités de 65 000 $ avant et d'environ 52 917 $ après.
Ces montants sont propres au contexte décrit : une région donnée, une grille tarifaire donnée, un ensemble de charges donné. Ils ne constituent pas un taux de réduction applicable ailleurs. La seule mention « à charge fonctionnelle comparable » suffit d'ailleurs à conditionner la lecture : si le périmètre fonctionnel, les volumes traités ou les niveaux de service ont bougé entre les deux périodes, le différentiel ne mesure plus un effet de migration mais un effet de périmètre.
La première question technique, avant même de parler de processeurs, est donc celle de la comparabilité des deux périodes. Un différentiel de coût n'a de sens FinOps que si l'unité de valeur produite est stable.
Il n'existe pas de correspondance un pour un entre x86 et Graviton
La migration décrite ne vise pas une seule génération de processeurs : m7g s'appuie sur Graviton3, tandis que r8g et c8g s'appuient sur Graviton4. Cela signifie qu'une même démarche de migration peut aboutir à des gains différents selon la famille retenue, puisque la génération sous-jacente et le profil de la famille ne sont pas identiques.
Surtout, il n'existe pas de remplacement universel « 1 pour 1 » entre une instance x86 et une instance Graviton. Le dimensionnement dépend du processeur, de la mémoire, de l'architecture logicielle et du profil de charge. Autrement dit, la correspondance de taille qui fonctionne pour un service asynchrone peu gourmand en CPU ne se transpose pas à une base de données, à un moteur de calcul ou à une passerelle réseau.
La conséquence pratique est simple : une migration Graviton ne se pilote pas avec une table de conversion figée, mais avec une campagne de mesure par workload. Le prix catalogue donne une direction ; il ne donne pas le dimensionnement.
Le protocole en cinq étapes, et la logique derrière chacune
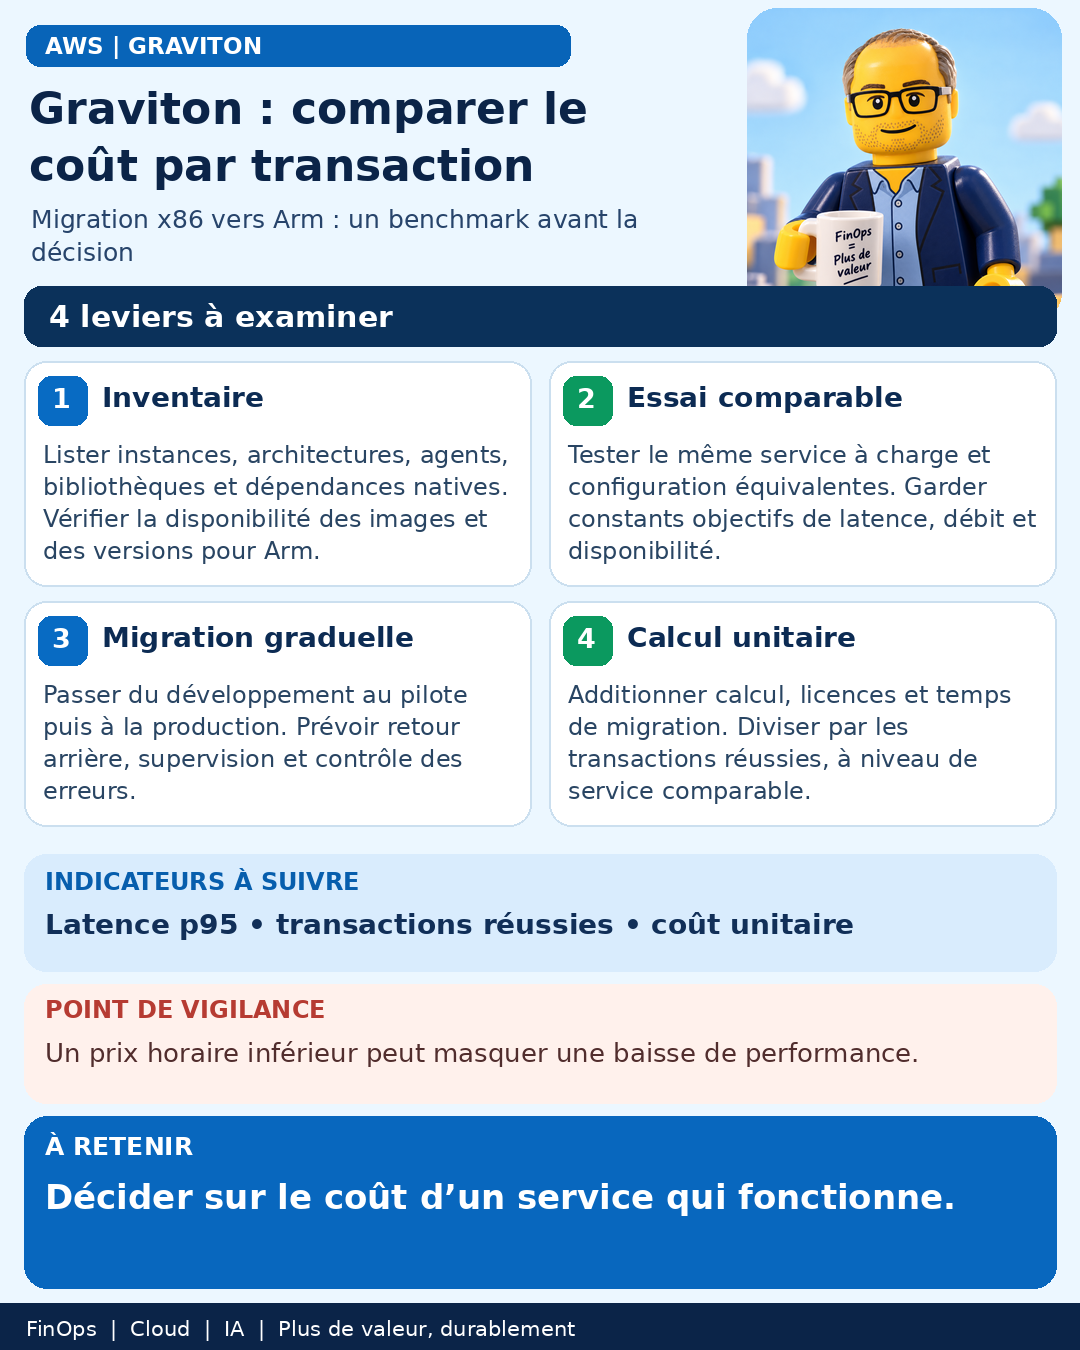
Le protocole retenu s'organise en cinq temps : benchmark par workload avant le choix de la famille et de la taille ; test de compatibilité des binaires, agents et dépendances ; recompilation des composants uniquement disponibles en x86 ; bascule progressive du développement au staging puis à la production ; mesure du coût par transaction avant et après migration.
L'ordre des étapes porte l'essentiel du raisonnement. Benchmarker avant de choisir la famille évite d'ancrer la décision sur un écart de prix horaire plutôt que sur un besoin réel de ressources. Le test de compatibilité intervient avant la recompilation, car il permet de distinguer ce qui fonctionne tel quel de ce qui exige un travail d'ingénierie. La recompilation est souvent la ligne de coût invisible : elle ne figure pas dans la facture cloud, mais elle consomme du temps d'équipe et peut retarder la bascule.
La progressivité développement, staging, production est un contrôle de risque plus qu'une optimisation. Elle permet de détecter une régression de performance ou un comportement inattendu sur une charge non critique avant d'engager la production. Enfin, la mesure du coût par transaction est ce qui protège la conclusion : c'est la seule métrique qui reste valable si les volumes changent après la migration.
Ce que dit réellement l'écart tarifaire
Dans la grille tarifaire et la région utilisées pour la comparaison, m7i.4xlarge est indiqué à environ 0,80 $ par heure et m7g.4xlarge à environ 0,64 $ par heure. L'écart horaire est net, mais il reste un écart de tarif catalogue pour une forme donnée : il ne prouve pas qu'une charge x86 donnée s'exécute à performance équivalente sur la forme Graviton correspondante. C'est précisément ce que le benchmark par workload doit établir.
La consolidation financière est la suivante : 780 000 $ par an, soit 65 000 $ par mois, avant migration ; 635 000 $ par an, soit environ 52 917 $ par mois, après ; un écart d'environ 12 083 $ par mois et de 145 000 $ par an.
À titre d'illustration, et non de prévision, un parc où dominent des familles mémoire ou calcul intensif conduirait à comparer d'autres couples de formes, avec des ratios horaires différents de celui cité ici. Le raisonnement reste identique, les montants changent. Toute projection doit donc être refaite sur la grille et la région effectivement utilisées, à la date de la décision.
Les critères de décision qui ne figurent pas sur la facture
Le coût par transaction est le meilleur arbitre, mais plusieurs critères conditionnent sa stabilité. La compatibilité des agents d'observabilité, de sécurité et de sauvegarde doit être vérifiée : un agent non supporté peut imposer de conserver des nœuds x86 et réduire le gain attendu. La recompilation des composants x86 only doit être estimée en jours-homme, pas seulement en faisabilité technique.
D'autres questions méritent d'être posées : les engagements de réduction déjà souscrits couvrent-ils encore le nouveau parc, et le différentiel affiché est-il réellement encaissé ou partiellement absorbé par un engagement devenu mal calibré ? Les licences éventuellement facturées par cœur ou par socket sont-elles sensibles au changement d'architecture ? Les tests de non-régression couvrent-ils la latence et pas seulement le débit ?
Enfin, il faut assumer le coût d'opportunité : mobiliser une équipe sur une recompilation pendant plusieurs semaines peut être moins rentable qu'un autre levier d'optimisation, même si le prix horaire est plus favorable sur le papier.
Checklist de travail, proposée à titre de suggestion
Cette liste est une suggestion de méthode, à adapter au contexte. Inventorier les instances x86 par famille, par workload, par coût mensuel et par coût par transaction, afin d'identifier les candidats à fort volume. Sélectionner un petit nombre de workloads représentatifs plutôt que de viser un basculement global.
Pour chaque candidat, définir une charge de référence reproductible, benchmarker x86 et Graviton avant le choix de la famille et de la taille, puis recalculer la taille nécessaire plutôt que de transposer l'existant. Dresser l'inventaire des binaires, agents et dépendances, identifier les composants uniquement disponibles en x86 et estimer l'effort de recompilation.
Fixer des critères de go/no-go explicites, incluant la non-régression de performance et pas uniquement le prix. Dérouler la bascule en développement, staging puis production, avec un plan de retour arrière. Mesurer le coût par transaction après migration sur le même périmètre qu'avant, dans la même région et sur la même grille tarifaire. Documenter enfin les workloads non migrés et la raison de ce choix : c'est souvent là que se trouve le prochain gain.
La question à trancher avant de généraliser
La question ouverte posée en conclusion de cette comparaison est utile comme cadre de travail : quel workload x86 a réellement été benchmarké face à Graviton ? Tant que la réponse reste vague, le différentiel de 145 000 $ reste une observation sur un parc donné, pas une référence transférable.
Le protocole décrit fournit un cadre raisonnable. Il ne dispense pas de documenter l'hypothèse « charge fonctionnelle comparable », de dater la grille tarifaire utilisée et de préciser la région. Un gain annoncé sans ces trois éléments est difficile à répliquer, et donc difficile à défendre en comité budgétaire.
Le post à l’origine de cette analyse
Article développé à partir du post LinkedIn. Les liens ci-dessous sont ceux du post d’origine ; leur présence ne constitue pas une vérification indépendante.
LinkedIn ↗