Le problème : une alerte tardive n'arrête rien
Une alerte en fin de mois arrive trop tard pour un agent qui répète ses appels aujourd'hui. La détection a posteriori ne stoppe pas la consommation en cours. La question n'est donc pas seulement de savoir combien a été dépensé, mais ce qui, dans le flux, peut interrompre une boucle coûteuse avant qu'elle ne s'emballe.
Ce décalage entre mesure et action est central. Un tableau de bord qui constate ne protège pas ; un garde-fou qui agit, oui. Encore faut-il définir ce qu'on arrête, pour qui, et à quel moment.
Trois questions pour cadrer la gouvernance
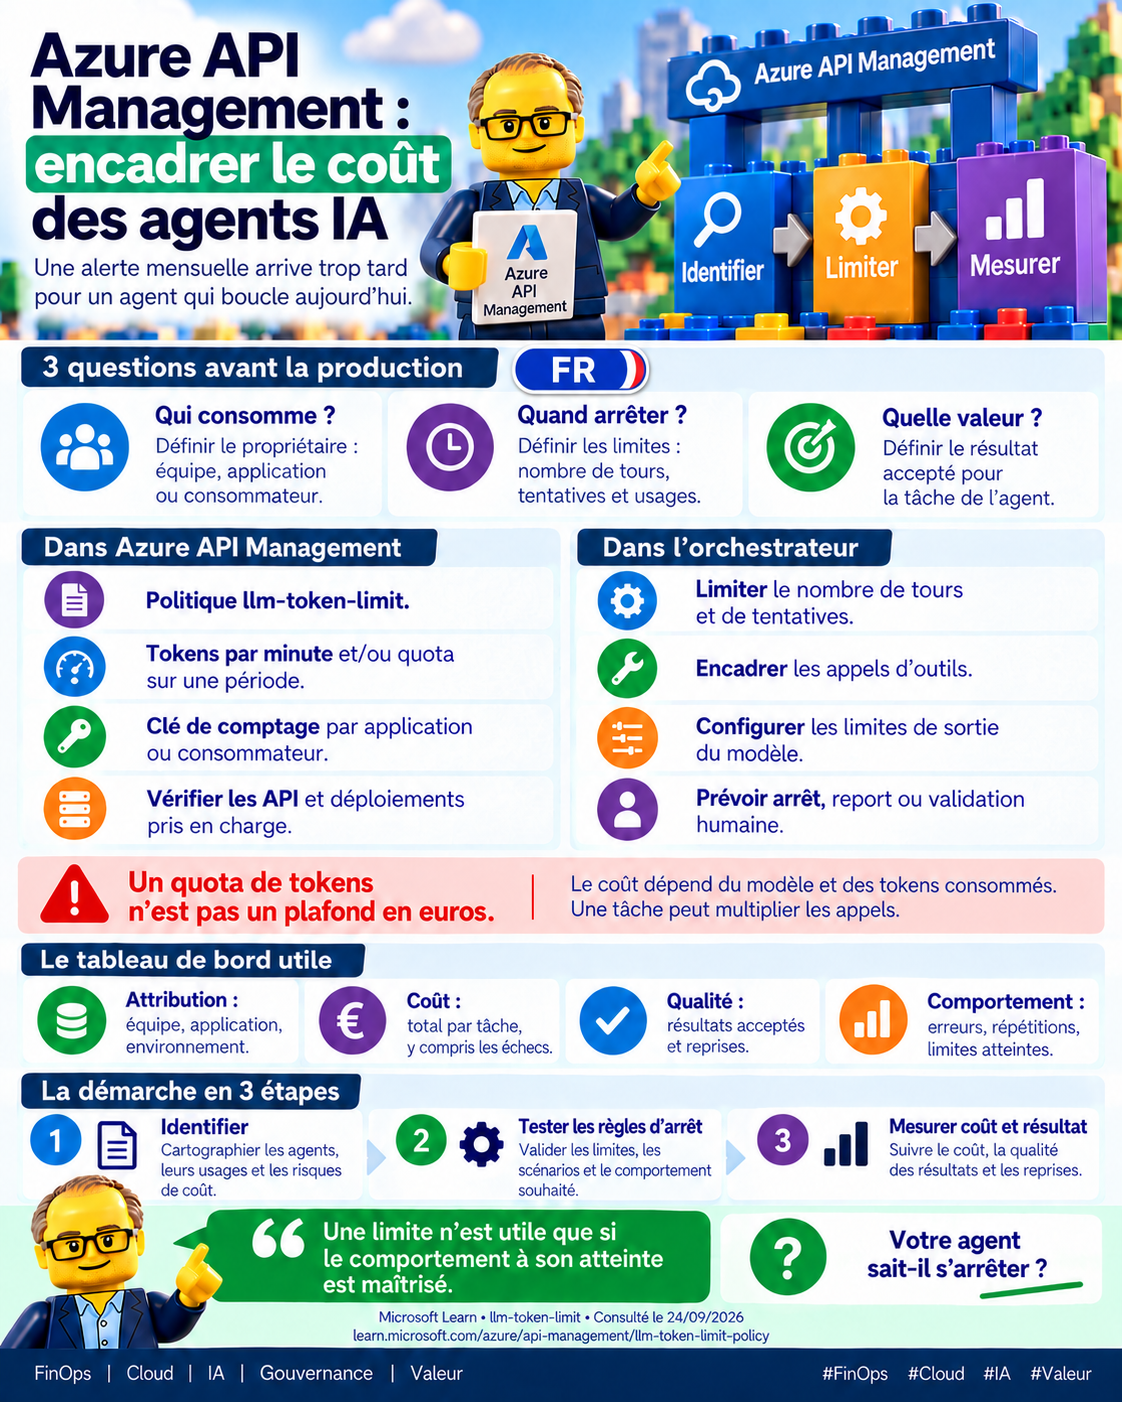
Pour gouverner sa dépense, je poserais trois questions : qui consomme, qu'est-ce qui arrête la consommation, quel résultat obtient-on ? Ces trois questions recouvrent trois fonctions distinctes : l'attribution, la protection et la mesure. Les traiter séparément aide à ne pas confondre un quota technique avec une politique de coût.
La première question porte sur l'identité. Sans clé fiable, on ne sait pas quel agent, quelle application ou quel consommateur a généré l'appel. La deuxième porte sur le mécanisme d'arrêt : un plafond, une limite de sortie, un nombre maximal de tentatives. La troisième porte sur la valeur produite : un coût sans résultat associé ne dit pas si la dépense était utile.
llm-token-limit : ce que la politique couvre, et ce qu'elle ne couvre pas
Dans Azure API Management, la politique llm-token-limit permet de limiter les tokens par minute et/ou d'appliquer un quota sur une période, selon une clé choisie. C'est un levier de contrôle du volume, pas un contrôle budgétaire direct.
Cela ne correspond pas automatiquement à un plafond en euros, ni à une limite de coût par tâche : le prix varie selon le modèle et la nature des tokens. La couverture dépend aussi des API et déploiements pris en charge. Autrement dit, la politique borne une quantité, mais la conversion en coût dépend de paramètres qu'elle ne fixe pas. Documentation Microsoft, consultée le 24 septembre 2026.
Attribution, protection, mesure : les trois piliers d'un dispositif complet
Un dispositif complet combine trois volets. L'attribution repose sur une clé fiable par application ou consommateur, reliée à un propriétaire. Sans propriétaire identifié, la responsabilité de la consommation se dilue.
La protection regroupe les quotas adaptés, les limites de sortie et le nombre maximal de tours, d'outils et de tentatives dans l'orchestrateur. Ces réglages ne sont pas que techniques : ils traduisent une décision sur ce qu'un agent a le droit de faire avant de s'arrêter.
La mesure porte sur le coût cumulé de la tâche, le taux de réussite, la qualité et les reprises humaines. Mesurer seulement le volume de tokens laisse de côté la question du résultat.
Que se passe-t-il lorsque la limite est atteinte ?
Il faut prévoir ce qui se passe à la limite : arrêt explicite, report ou validation humaine. Ce choix est un arbitrage. Un arrêt explicite protège la dépense mais peut interrompre une tâche utile. Un report lisse la charge mais suppose une file d'attente et une reprise maîtrisée. Une validation humaine ajoute du contrôle, au prix d'un délai et d'une charge d'exploitation.
Un point d'attention : une relance automatique sans limite peut annuler le garde-fou. Si l'orchestrateur réessaie indéfiniment après un refus, la limite devient décorative. La règle d'arrêt doit donc être testée, pas seulement configurée.
Rapprocher coût et résultat dans le tableau de bord
Le tableau de bord doit rapprocher coût et résultat, puis distinguer trafic utile, erreurs et répétitions. Un budget mensuel seul ne décrit pas le comportement d'un agent. Il indique un total, pas la dynamique qui l'a produit.
Par exemple, à titre d'illustration, un agent qui consomme beaucoup pour un taux de réussite faible et de nombreuses reprises humaines n'a pas le même profil qu'un agent qui consomme autant mais résout les tâches du premier coup. Les deux peuvent afficher le même coût cumulé, avec des conséquences opérationnelles différentes.
Questions pratiques avant de généraliser
Vos agents ont-ils une règle d'arrêt testée et un responsable de leur consommation ? La question mérite d'être posée agent par agent, car une règle non testée reste une intention.
Quelques points à vérifier : la clé d'attribution est-elle fiable et reliée à un propriétaire ? Les quotas sont-ils adaptés au modèle et à la nature des tokens ? Le nombre de tours, d'outils et de tentatives est-il borné dans l'orchestrateur ? Que se passe-t-il exactement à la limite ? Le tableau de bord distingue-t-il trafic utile, erreurs et répétitions ?
Ces vérifications ne garantissent pas un plafond en euros, puisque la politique llm-token-limit ne le fournit pas automatiquement. Elles rendent en revanche la consommation observable, attribuable et interruptible, ce qui est la condition d'une gouvernance utile.
Le post à l’origine de cette analyse
Article développé à partir du post LinkedIn. Les liens ci-dessous sont ceux du post d’origine ; leur présence ne constitue pas une vérification indépendante.
LinkedIn ↗