Le périmètre de l’incident rapporté par Reuters
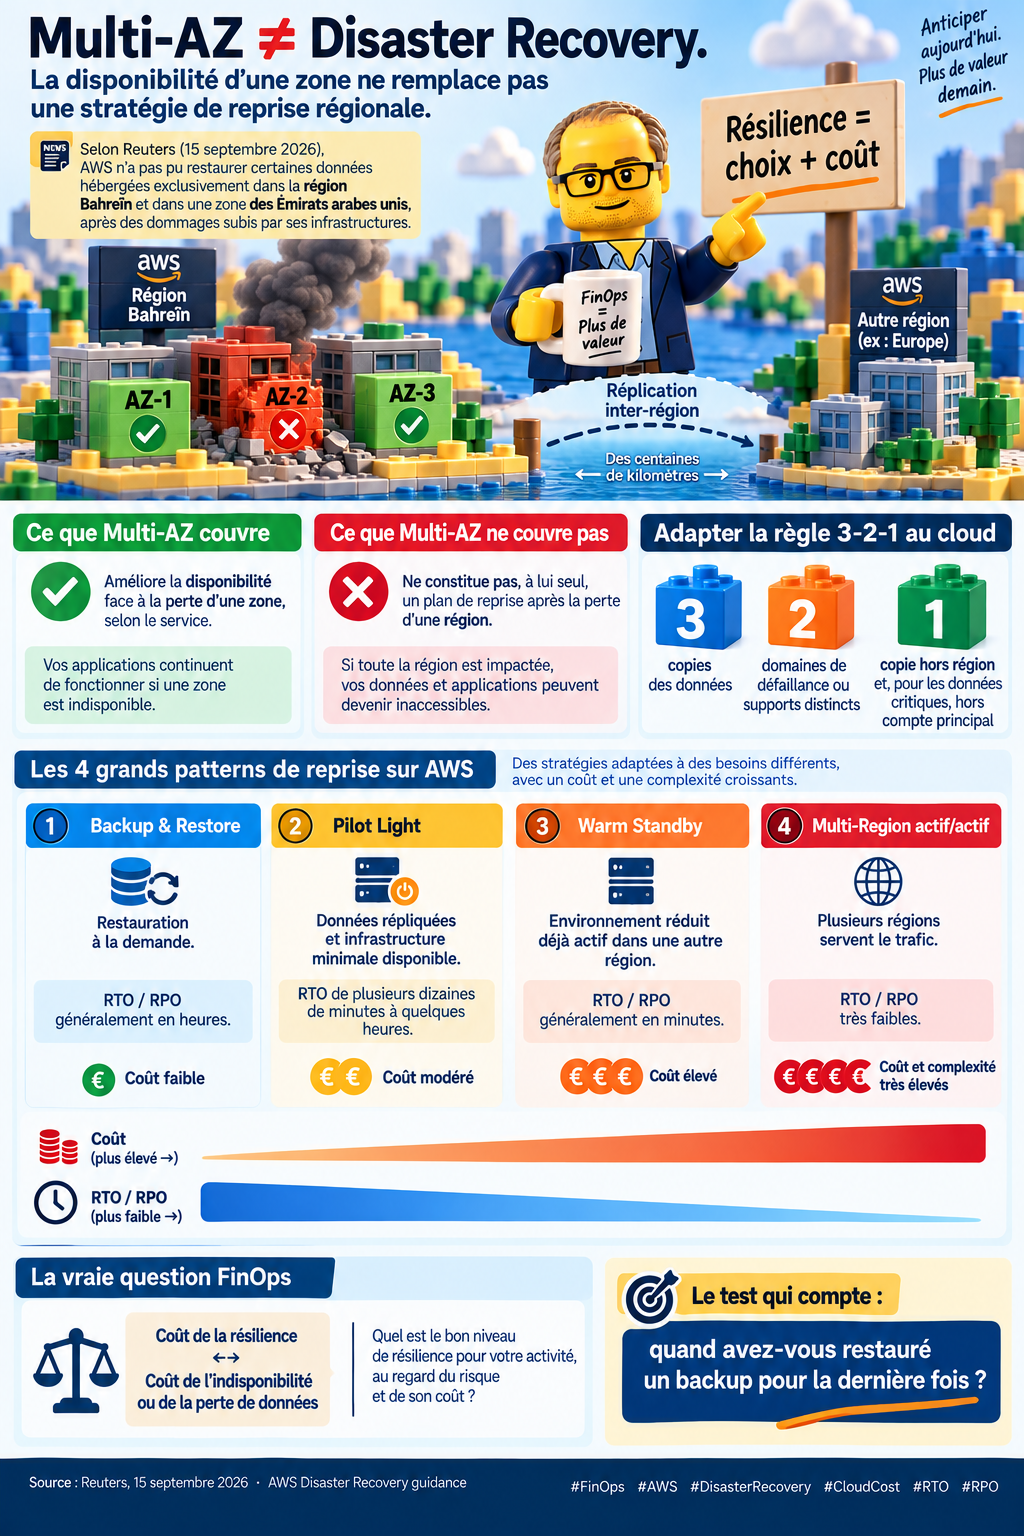
Selon Reuters, dans un article daté du 15 septembre 2026, AWS a indiqué ne pas pouvoir restaurer certaines données hébergées exclusivement dans la région Bahreïn et dans une zone des Émirats arabes unis, après les dommages subis par ses infrastructures en 2026. Cette information reste attribuée à Reuters et n'est pas vérifiée indépendamment ici.
Le périmètre compte : il est question de certaines données hébergées exclusivement dans les emplacements concernés. Ce récit ne permet pas de conclure à la perte de toutes les données de ces régions. Il invite à vérifier où résident les copies sur lesquelles repose votre propre reprise.
Pour chaque application, il faut préciser les scénarios de défaillance couverts. Une perte de zone, une perte de région ou un problème sur le compte principal ne demandent pas nécessairement la même organisation des sauvegardes et des moyens de reprise.
Distinguer disponibilité et reprise après perte d’une région
Selon le service, Multi-AZ améliore la disponibilité face à la perte d'une zone de disponibilité. Cette protection répond à un scénario local. Elle ne constitue pas, à elle seule, un plan de reprise après la perte d'une région.
Le plan de reprise doit identifier les données récupérables, leur emplacement et les étapes permettant de remettre le service en fonctionnement. Les objectifs de délai et de perte de données acceptable doivent être définis avec les responsables métier.
Les termes RTO et RPO servent à exprimer ces objectifs : le délai de reprise visé et la perte de données acceptable. Ils doivent être précisés par application et confrontés aux capacités testées. Un objectif inscrit dans un document ne suffit pas à démontrer qu'il sera tenu.
Adapter la règle 3-2-1 aux domaines de défaillance
La règle 3-2-1 vient historiquement de la sauvegarde. Une adaptation au cloud peut retenir 3 copies des données, 2 domaines de défaillance ou supports distincts, et 1 copie hors de la région. Pour les données critiques, cette dernière peut aussi être placée hors du compte principal.
Il faut cartographier les copies et comprendre ce qui pourrait les rendre indisponibles ensemble. Le nombre de copies ne renseigne pas, à lui seul, sur leur séparation. Vérifiez les régions, les comptes et les procédures permettant d'accéder aux sauvegardes lors de la reprise.
Cette adaptation est une piste de conception à ajuster à vos obligations et à vos scénarios de risque. Son coût doit inclure le stockage supplémentaire, les transferts nécessaires et le travail de préparation puis de vérification des restaurations.
Comparer les quatre patterns de reprise
AWS présente quatre grands patterns. Backup & Restore repose sur une restauration à la demande, avec des RTO et RPO généralement mesurés en heures. Les sauvegardes et les étapes de reconstruction doivent être incluses dans le test de reprise.
Pilot Light conserve des données répliquées et une infrastructure minimale disponible. Le RTO indiqué se situe entre plusieurs dizaines de minutes et quelques heures. Il faut prévoir comment étendre cette infrastructure lorsque la reprise est déclenchée.
Warm Standby fait fonctionner une version réduite de l'environnement dans une autre région. Les RTO et RPO sont généralement mesurés en minutes. Le coût doit intégrer cette capacité secondaire et sa préparation à la charge attendue.
En Multi-Region actif/actif, plusieurs régions servent le trafic. Les RTO et RPO visés sont très faibles, avec un coût et une complexité élevés. Ces ordres de grandeur restent indicatifs : les résultats dépendent de l'application, des données et des procédures testées.
Une organisation peut retenir des patterns différents selon la criticité de ses applications. Il faut comparer chaque option au besoin réel, en incluant les dépendances qui doivent également fonctionner au moment de la reprise.
Mesurer le coût et tester la restauration
L'arbitrage FinOps consiste à comparer le coût du niveau de résilience demandé au coût estimé de l'indisponibilité ou de la perte des données. Chiffrez les copies, les transferts, l'environnement secondaire et les tests. Faites valider le besoin et le budget par les équipes concernées.
Comme démarche de départ, inventoriez les applications et leurs données critiques, documentez les RTO et RPO, puis vérifiez les copies hors région et, pour les données critiques, hors compte. Choisissez un pattern compatible avec ces objectifs et planifiez un exercice.
Lors de la restauration, contrôlez les données récupérées, les étapes exécutées et les délais réellement obtenus. Notez les écarts avec le plan et les actions correctives. Le prochain exercice doit permettre de vérifier ces corrections, puis d'ajuster le budget et les procédures si les besoins ont changé.
Le post à l’origine de cette analyse
Article développé à partir du post LinkedIn. Les liens ci-dessous sont ceux du post d’origine ; leur présence ne constitue pas une vérification indépendante.
LinkedIn ↗