Le profil d’accès qui a motivé l’optimisation
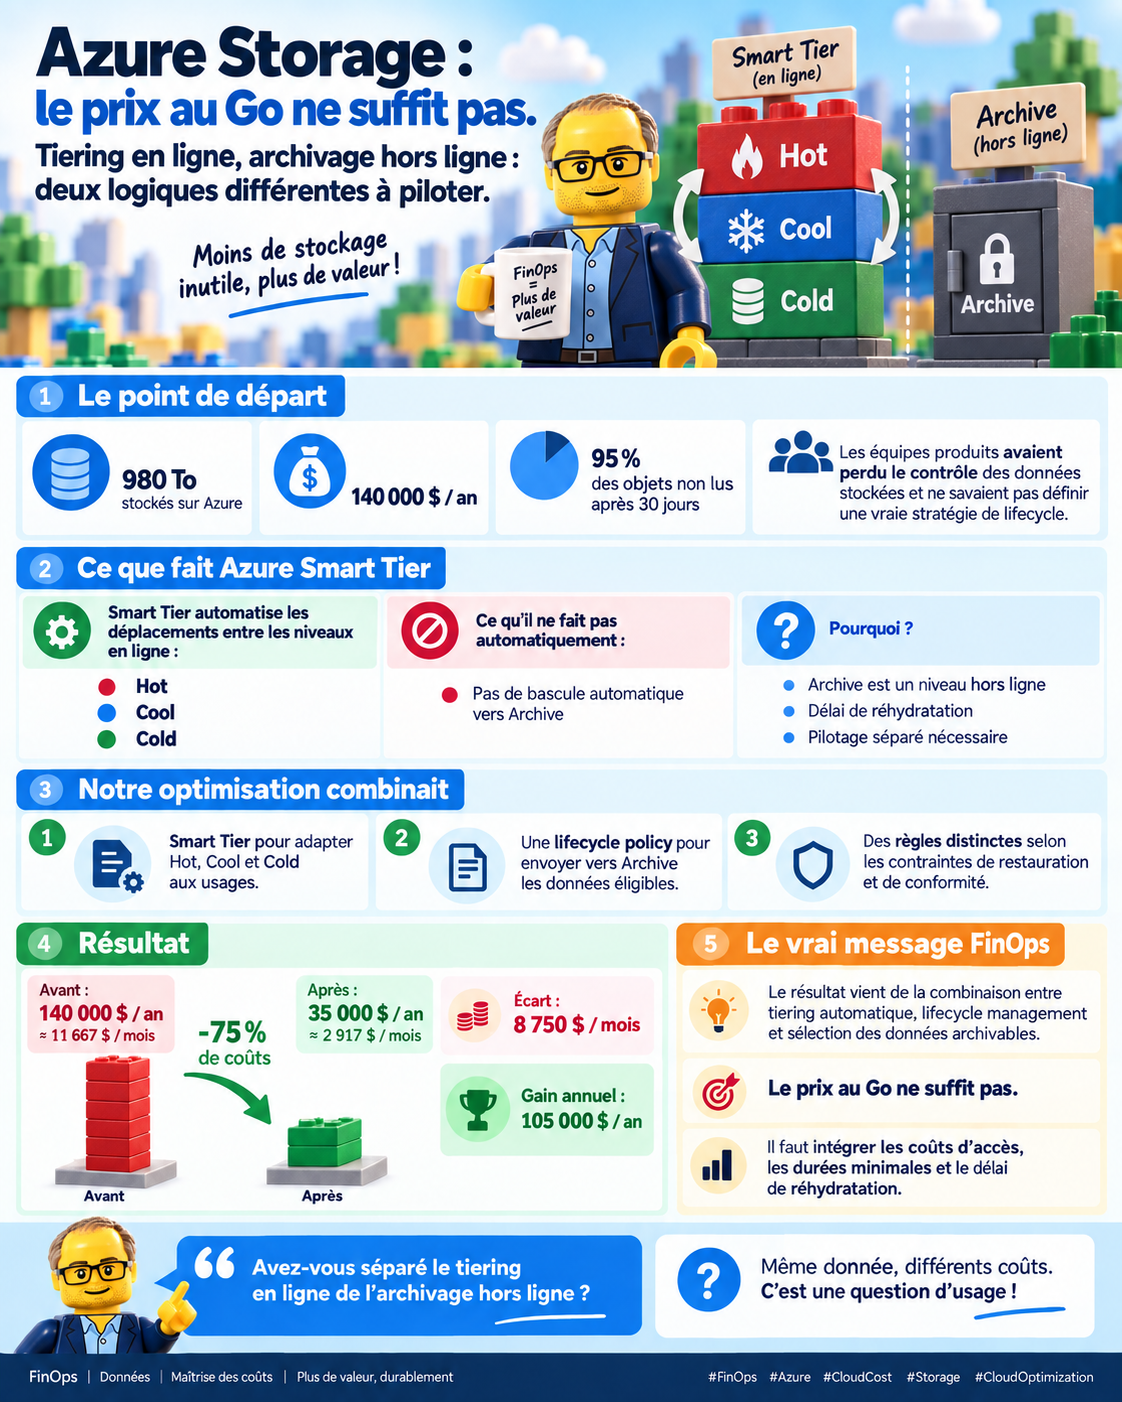
Nous stockions 980 To sur Azure pour 140 000 $ par an, soit environ 11 667 $ par mois. Sur ce périmètre, 95 % des objets n'étaient plus lus après 30 jours. Cette observation a servi à revoir la répartition des données entre les niveaux de stockage.
Le pourcentage porte sur les objets de cet environnement. Il ne doit pas être transposé à un autre parc sans mesure. Il ne dit pas non plus, à lui seul, quelle part du volume ou de la facture correspond à ces objets : leurs tailles et leurs contraintes doivent être examinées.
L'analyse doit rapprocher les accès observés des besoins futurs de lecture et de restauration. Un objet peu consulté peut rester nécessaire rapidement. Les règles de conformité et de conservation peuvent aussi limiter les déplacements possibles.
Ce que le tiering en ligne couvre
Azure Smart Tier est présenté comme un mécanisme qui automatise les déplacements entre les niveaux en ligne Hot, Cool et Cold. Il permet d'adapter ce placement aux usages. Ces caractéristiques restent à confirmer dans la documentation Microsoft applicable à votre configuration.
Smart Tier ne déplace pas automatiquement les objets vers Archive. Archive est un niveau hors ligne, avec un délai de réhydratation avant de pouvoir relire les données. Ce passage doit être piloté séparément, par une règle de cycle de vie ou une action explicite.
Il faut donc distinguer les données qui restent dans les niveaux en ligne des candidates à Archive. La décision d'archivage demande un accord sur le délai acceptable et sur les règles de conservation. Une absence de lecture récente ne suffit pas à justifier ce choix.
Les trois composantes de notre configuration
Notre optimisation combinait Smart Tier pour adapter Hot, Cool et Cold aux usages, une lifecycle policy pour envoyer les données éligibles vers Archive, et des règles distinctes selon les contraintes de restauration et de conformité.
La sélection des données archivables était donc une partie du travail. Les règles devaient différencier les jeux de données et leurs besoins de récupération. Appliquer le même déplacement à tout le stockage aurait ignoré ces différences.
Pour reprendre cette démarche, commencez par documenter les critères d'éligibilité à Archive et les personnes qui les valident. Vérifiez ensuite que les règles en ligne et hors ligne correspondent à cette décision. Ce sont des suggestions de méthode à adapter à votre propre environnement.
Lire les gains avec leur périmètre
La facture annuelle est passée de 140 000 $ à 35 000 $. Les équivalents mensuels sont d'environ 11 667 $ avant et 2 917 $ après. L'écart de 8 750 $ par mois correspond à 105 000 $ par an : 140 000 - 35 000 = 105 000.
Ce résultat vient de la combinaison du tiering automatique, du lifecycle management et de la sélection des données archivables. Il ne permet pas d'attribuer un montant d'économie à chaque levier pris séparément. Ces chiffres décrivent ce cas et ne sont pas vérifiés indépendamment ici.
Le gain d'un autre environnement doit être recalculé avec ses volumes, ses accès et ses règles de conservation. Une configuration comportant davantage de relectures ou moins de données éligibles à Archive peut conduire à un résultat différent.
Estimer les accès et tester la réhydratation
Le prix au Go ne suffit pas à comparer les scénarios. Le calcul doit inclure les coûts d'accès, les durées minimales applicables et le délai de réhydratation. Vérifiez leur compatibilité avec la durée de vie prévue des données et les besoins de restauration.
Pour préparer un pilote, mesurez les accès, identifiez les objets inactifs après 30 jours et segmentez les jeux de données selon leurs contraintes. Documentez les règles vers Archive, puis testez la récupération sur le périmètre retenu avant de généraliser.
Après mise en œuvre, rapprochez la facture des usages observés et contrôlez les données réhydratées. Si des relectures deviennent récurrentes, examinez les règles concernées. Le suivi doit permettre de corriger le placement au lieu de conserver une économie estimée qui ne correspond plus aux accès réels.
Le post à l’origine de cette analyse
Article développé à partir du post LinkedIn. Les liens ci-dessous sont ceux du post d’origine ; leur présence ne constitue pas une vérification indépendante.
LinkedIn ↗